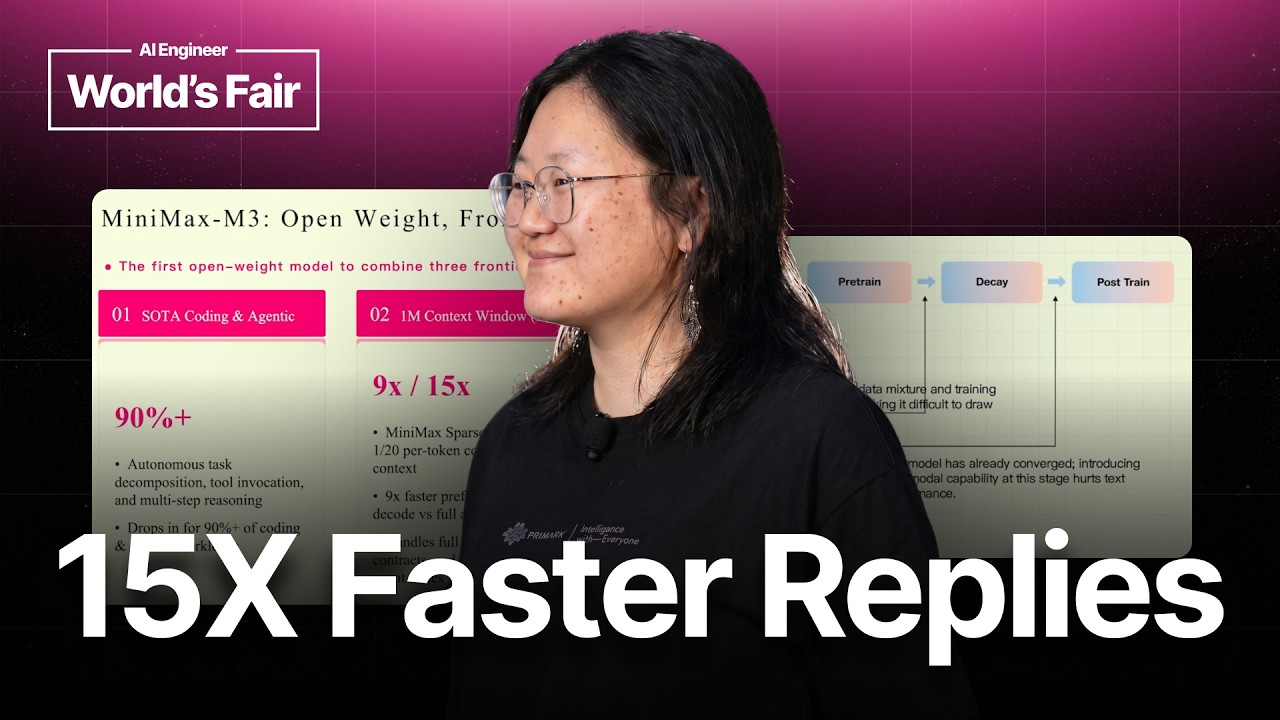
URL: https://www.youtube.com/watch?v=htod7Nv1cBc 날짜: 2026-10-11 채널: latentspacepod 발표자: Olive Song, MiniMax 강화학습 연구자
📌 핵심 질문 / 이 영상이 다루는 핵심 논점
==MiniMax M3는 에이전트형 프로그래밍, 백만 토큰급 장문 컨텍스트, 네이티브 멀티모달리티를 하나의 오픈 웨이트 모델에 결합하면서, MiniMax Sparse Attention(MSA)과 처음부터 멀티모달 데이터를 섞어 학습하는 전략으로 성능과 시스템 효율을 함께 확보했다.==
- M3는 지능형 프로그래밍·에이전트 기능, 최대 100만 토큰 컨텍스트, 네이티브 멀티모달 이해라는 세 축을 갖는다.
- MSA는 전체 토큰에 어텐션을 계산하지 않고 인덱싱 브랜치(indexing branch)가 고득점 블록을 찾아 메인 브랜치가 그 부분만 읽게 하며, full attention 대비 프리필(prefill)은 9배, 디코딩(decoding)은 15배 빠르다.
- MSA는 알고리즘만 바꾼 결과가 아니라 GQA의 헤드 다양성과 GPU 메모리 접근 패턴을 함께 고려한 알고리즘·인프라 공동 설계(joint design)다.
- M3는 텍스트 모델을 먼저 완성한 뒤 시각 능력을 덧붙이지 않고, 처음부터 텍스트·비전 데이터를 함께 사용해 텍스트 성능을 거의 훼손하지 않는 멀티모달 모델을 학습했다.
MiniMax는 언어·음성·영상·소프트웨어 에이전트를 모두 자체 개발해 온 연구 조직이며, M3는 이 폭넓은 기반 위에서 긴 코드베이스와 장시간 상호작용을 처리하는 에이전트 모델을 만들려는 시도다. 희소 어텐션의 선택 단위를 토큰에서 블록으로 바꾸고 GQA 헤드별 선택 다양성을 유지한 덕분에 백만 토큰 컨텍스트를 실용적인 효율로 확장할 수 있었다. 동시에 이미지와 영상을 비전 인코더의 부가 입력으로 취급하지 않고 언어 정보와 같은 학습 과정에 넣어 시각·텍스트 표현을 자연스럽게 통합했다.
1. MiniMax M3의 목표와 세 가지 기둥
MiniMax M3는 오픈 웨이트와 선도적 성능을 동시에 목표로 삼은 멀티모달 에이전트 모델이다.
1.1. MiniMax의 연구 기반과 M3의 출발점
-
멀티모달 연구 조직으로서의 MiniMax
- 언어 모델(Large Language Model): MiniMax는 자체 대규모 언어 모델을 발표하며 언어 모델링 경험을 쌓았다.
- 음성 인식(Speech Recognition): 자체 음성 인식 모델을 개발해 음성 입력을 다뤄 왔다.
- 영상 생성(Video Generation): 자체 영상 생성 모델도 연구해 시각 데이터와 생성 시스템을 구축했다.
- 소프트웨어 에이전트(Software Agent): 소프트웨어 에이전트 모델을 개발해 복합 작업 수행을 연구했다.
- 희소한 종합 역량: 언어·음성·영상·에이전트·멀티모달리티를 함께 연구하는 세계적으로 드문 연구실 중 하나라는 점이 M3 설계의 기반이 됐다.
-
오픈 웨이트 모델로서의 M3
- 공개와 성능의 동시 추구: MiniMax는 M3를 오픈 웨이트(open weights)로 출시하면서 선도적인 성능을 지향했다.
- 세 능력의 결합: M3는 지능형 프로그래밍·에이전트, 초장문 컨텍스트, 처음부터 학습한 멀티모달리티를 하나의 모델에 결합한다.
1.2. 첫 번째 기둥: 지능형 프로그래밍과 에이전트
-
프로그래밍 작업의 자동 분해
- 복합 작업 처리: M3는 상상할 수 있는 다양한 에이전트 작업을 수행할 수 있다.
- 작업 분해(Task Decomposition): 큰 작업을 하위 작업으로 자동 분해해 순차적·도구 기반 실행이 가능하도록 한다.
- 프로그래밍 에이전트 내 동작: 기존 프로그래밍 에이전트의 작업 흐름 안에서 직접 작동할 수 있다.
-
개발 업무의 광범위한 자동화
- 90% 처리 목표: M3는 사용자가 현재 수행하는 프로그래밍 작업의 약 90%를 처리할 수 있도록 설계됐다.
- 컴퓨터 사용 에이전트(Computer-Use Agent): 코드 작성뿐 아니라 컴퓨터를 조작하는 에이전트 애플리케이션으로 확장할 수 있다.
- 실용적 의미: 작업 분해·코드베이스 읽기·도구 호출을 한 흐름으로 묶어 에이전트형 개발 환경을 지향한다.
1.3. 두 번째 기둥: 100만 토큰 컨텍스트
-
초장문 입력의 수용
- 컨텍스트 창(Context Window): M3는 최대 100만 개의 기호 또는 토큰에 해당하는 컨텍스트를 처리할 수 있다.
- 긴 상호작용: 장시간 이어지는 사용자 상호작용 전체를 한 컨텍스트에 유지할 수 있다.
- 전체 코드베이스 처리: 프로젝트의 전체 코드베이스를 한 번에 읽고 추론하는 용도에 맞는다.
-
긴 컨텍스트의 시스템 요구
- 계산량 문제: 전체 어텐션(full attention)은 컨텍스트가 길어질수록 모든 토큰 쌍을 다루는 비용이 커진다.
- MSA의 역할: 희소 어텐션으로 필요한 블록만 읽어 100만 토큰 학습을 높은 효율로 확장했다.
- 속도 개선: MSA는 full attention과 비교해 초기 프리필이 9배 빠르고 디코딩이 15배 빠르다.
1.4. 세 번째 기둥: 처음부터 학습한 네이티브 멀티모달리티
-
텍스트와 비전의 동시 기반
- 처음부터 통합: M3는 처음부터 텍스트와 비전을 이해하도록 학습됐다.
- 언어 생성과 시각 이해: 언어 생성(Language Generation)과 시각 이해(Visual Comprehension)를 처음부터 결합했다.
- 초기부터 얻는 표현: 두 능력이 사후 부착물이 아니라 모델의 기본 표현 안에서 함께 형성된다.
-
응용 범위의 확장
- 더 넓은 애플리케이션: 언어·비전 능력이 함께 있으면 컴퓨터 사용 에이전트 같은 응용을 만들기 쉽다.
- 네이티브 설계의 의미: 시각 정보를 나중에 덧붙이는 방식보다 텍스트와 시각 정보가 상호작용하는 작업에 자연스럽게 대응한다.
2. MiniMax Sparse Attention(MSA)의 기본 설계
MSA의 설계 원칙은 단순한 구조가 더 나은 확장 특성을 만든다는 믿음이며, 이 원칙은 알고리즘부터 시스템 코어까지 전체 설계 과정에 적용됐다.
2.1. 두 브랜치로 분리한 어텐션
-
인덱싱 브랜치(Indexing Branch)
- 가벼운 후보 탐색: 인덱싱 브랜치는 전체를 정밀하게 처리하지 않고 가벼운 어텐션(light attention) 계산으로 중요한 후보를 찾는다.
- 헤드 구성: 인덱싱 브랜치는 쿼리 헤드(query head) 4개와 키 헤드(key head) 1개를 사용한다.
- KL 손실(KL Loss): 인덱싱 브랜치는 메인 브랜치의 어텐션 점수 분포를 따라가도록 KL 손실 함수로 학습된다.
- 고득점 기호 식별: 이 브랜치가 높은 어텐션 점수를 받을 기호 또는 위치를 식별한다.
-
메인 또는 산개 브랜치(Main/Scatter Branch)
- 부분집합 처리: 메인 브랜치는 모든 기호를 처리하지 않고 인덱싱 브랜치가 선택한 부분집합만 처리한다.
- 선택 블록 사용: 인덱싱 브랜치가 고른 블록을 사용해 어텐션 계산에 필요한 키(key)와 값(value)을 결정한다.
- 계산 집중: 전체 시퀀스에 동일한 비용을 쓰는 대신 정보량이 높다고 판단된 영역에 계산을 집중한다.
-
선택 흐름의 요약
- 먼저 찾기: 인덱싱 브랜치가 적은 비용으로 중요한 기호·블록의 위치를 찾는다.
- 그다음 읽기: 메인 브랜치가 선택된 블록의 키·값만 불러와 실제 어텐션을 계산한다.
- 희소성의 근거: 선택되지 않은 나머지 기호는 메인 어텐션에서 제외되므로 긴 컨텍스트의 비용을 줄인다.
2.2. 알고리즘·인프라 공동 설계
-
알고리즘만으로 해결하지 않는 원칙
- 공동 설계(Joint Design): M3의 설계는 알고리즘만 보고 결정하지 않고 알고리즘과 인프라를 함께 설계했다.
- 실제 실행 가능성: 계산 그래프의 이론적 효율뿐 아니라 GPU 메모리 접근과 구현 가능성을 성능의 일부로 봤다.
-
DSA에서 얻은 출발점
- 견고하지만 조건부인 설계: DSA(DeepSeek Sparse Attention)는 매우 견고한 설계이며 MQA와 큰 헤드 차원(head dimension)의 조합으로 DeepSeek 고유 아키텍처에 맞게 크게 개선됐다.
- GQA로의 이동: 더 일반적인 GQA(Grouped-Query Attention) 구조에 같은 방식을 그대로 옮기면 알고리즘과 인프라 양쪽에서 문제가 생긴다.
- 재설계의 필요: MiniMax는 기존 희소 어텐션을 단순히 빌리지 않고 GQA 제약과 실제 시스템 효율을 기준으로 구조를 다시 설계했다.
2.3. GQA에서 기존 희소 선택을 그대로 쓸 때의 문제
-
KV 헤드 다양성의 소실
- GQA의 장점: GQA는 여러 KV 헤드(key-value heads)를 두어 서로 다른 KV 조합에서 더 큰 다양성과 유연성을 제공한다.
- 동일한 선택의 부작용: 같은 기호 선택 전략을 모든 헤드에 적용하면 여러 KV 헤드가 정확히 같은 기호에 집중한다.
- 다양성의 무효화: 결국 GQA가 제공해야 하는 헤드별 선택 다양성이 사라진다.
-
GPU 메모리 접근 비효율
- 인접 데이터 선호: GPU는 인접한 데이터를 한 번에 읽을 때 훨씬 효율적이다.
- MQA의 배치: 8개 KV를 MQA로 배치하면 하나의 KV 헤드에 큰 헤드 차원, 예를 들어 1×512를 둔 것처럼 볼 수 있어 비교적 연속적인 읽기가 가능하다.
- GQA의 분할: 같은 전체 차원을 여러 KV 헤드로 나누면 4×128처럼 쪼개진다.
- 독립 메모리 읽기: GPU는 서로 다른 KV 헤드에서 여러 번 독립적으로 읽어야 하므로 메모리 접근 비용이 커지고 계산량 대 메모리 접근량(computation-to-memory access ratio)이 낮아진다.
-
토큰 단위 Top-K의 병렬화 한계
- 후보 수: 인덱서는 기호 수준의 매우 많은 후보에서 중요한 기호를 고르기 위해 Top-K 결과를 계산해야 한다.
- 데이터 의존성: Top-K에는 본질적인 데이터 의존성이 있어 GPU에서 완전히 병렬화하기 어렵다.
- 통합 비용: 기호 수준 선택은 상당한 계산 비용과 구현·통합 비용을 부과한다.
2.4. MSA가 선택한 해결책
-
KV 헤드별 선택을 보존
- 기존 방식의 문제: 원래 설계는 모든 인덱싱 브랜치 헤드의 결과를 하나의 선택 기호 집합으로 합쳤다.
- 그룹화 제거: MSA는 인덱싱 브랜치 출력의 그룹화를 제거했다.
- 선택 차이 유지: GQA를 사용할 때 KV 헤드마다 선택 결과의 차이를 유지해 서로 다른 기호 집합에 어텐션을 둘 수 있게 했다.
- GQA 다양성 보존: 모든 헤드가 같은 희소 패턴을 공유하도록 강제하지 않아 GQA의 원래 장점을 살렸다.
-
토큰 선택에서 블록 검색으로 전환
- 블록 수준 검색(Block-Level Retrieval): MSA는 토큰 수준 선택을 블록 수준 검색으로 바꿨다.
- 후보 수 감소: 블록으로 묶으면 후보 수가 크게 줄어 최적 키를 계산하고 결과를 결합하는 비용이 낮아진다.
- 하드웨어 친화성: 블록 단위 접근은 장치가 다루기 더 편하고 메모리 접근 효율을 높인다.
- 비율 개선: 계산량 대 메모리 접근량 비율을 높여 실제 GPU 실행 효율을 개선한다.
- 성능 보존: 이 구조가 성능을 크게 떨어뜨리지 않는다는 점도 확인했다.
-
훈련·추론 코어 구현
- 전용 코어: MiniMax는 학습(training)과 추론(inference) 양쪽에 효율적인 코어를 설계했다.
- 시스템 구성요소: 발표에서 코어의 세부 구현은 다루지 않았지만, 이 코어가 희소 어텐션을 실용적이고 효과적인 시스템으로 만든다.
- 백만 토큰 확장: 알고리즘·블록 접근·전용 코어의 결합으로 M3를 백만 토큰 컨텍스트까지 높은 효율로 학습시킬 수 있었다.
3. 텍스트 성능을 보존하는 네이티브 멀티모달 학습
M3의 멀티모달 전략은 완성된 텍스트 모델에 시각 능력을 추가하는 방식의 부작용을 피하고, 텍스트와 비전을 처음부터 함께 학습하는 것이다.
3.1. 멀티모달 데이터의 처음부터 학습
-
기존 오픈 웨이트 모델과의 차이
- 스크래치 학습: M3는 멀티모달 데이터로 처음부터 학습됐다.
- 텍스트·비전의 동시 이해: 모델은 첫 단계부터 텍스트와 비전을 이해하도록 훈련됐다.
- 다른 출발점: 이는 현재의 일반적인 오픈 웨이트 모델이 텍스트 능력을 먼저 만든 뒤 비전을 추가하는 방식과 다르다.
-
핵심 난제
- 독립 비전·언어 모델의 한계: 당시 시각-언어 독립 모델은 적용할 수 있는 시나리오가 비교적 제한적이었다.
- 통합의 어려움: 이미 만들어진 텍스트 이해 능력에 멀티모달 능력을 통합하면 텍스트 기반 성능이 손상될 수 있다.
- 설계 질문: 시각 능력을 넣으면서 underlying text, 즉 기반 텍스트 성능을 훼손하지 않는 방법이 핵심 질문이었다.
3.2. 시도한 대규모 학습 전략과 한계
-
사후 멀티모달 학습(CPT-style)
- 방법: 프리트레이닝(pre-training)이 끝난 뒤 멀티모달 학습을 추가하는 방식이다.
- 수렴 이후의 간섭: 모델이 이미 크게 수렴한 상태에서 멀티모달 데이터를 넣으면 기존에 습득한 텍스트 능력과 충돌한다.
- 성능 저하: 시각·멀티모달 데이터가 텍스트 능력의 훼손과 저하를 일으킨다.
-
프리트레이닝 전후에 멀티모달리티를 끼워 넣는 방식
- 방법: 일정량의 텍스트·코드를 본 뒤 멀티모달 학습을 시작하는 전략도 시도했다.
- 데이터 혼합 민감성: 결과가 데이터 혼합 비율과 학습률(learning rate) 같은 하이퍼파라미터에 매우 민감했다.
- 재현성 문제: 어떤 실험에서는 낮은 학습률이 성능 하락을 줄였지만, 다른 실험에서도 같은 결과가 일반화되지는 않았다.
- 임의 변경의 한계: 광범위한 프리트레이닝 중 멀티모달 학습만을 위해 파라미터를 무작위로 바꿀 수는 없었다.
-
최종 전략: 진정한 처음부터의 멀티모달 학습
- 처음부터 도입: 멀티모달 능력을 텍스트 구조가 이미 형성된 뒤 추가하지 않고 학습 시작점부터 넣었다.
- 텍스트 예산 고정: 같은 텍스트 토큰 예산을 사용했을 때 텍스트 능력에 사실상 해가 거의 없었다.
- 통합의 목표: 단순히 시각 능력을 추가하는 것이 아니라 강한 텍스트 능력을 유지하면서 멀티모달 정보를 모델 안에 통합했다.
3.3. 어텐션 맵이 보여준 통합 정도
-
CPT-style 학습의 분리
- 낮은 상호 주의: CPT 방식의 멀티모달 템플릿은 텍스트 기호와 시각 기호에 거의 주의를 기울이지 않았다.
- 어두운 시각 영역: 어텐션 맵에서 시각 기호 영역이 대부분 어둡게 나타났다.
- 해석: 텍스트와 시각 정보가 모델 안에서 완전히 통합되지 않았다는 신호다.
-
처음부터 학습한 멀티모달 표현
- 통합된 어텐션 맵: 처음부터 멀티모달로 학습한 모델의 어텐션 맵은 훨씬 더 통합된 모습을 보였다.
- 명확한 경계의 부재: 텍스트 기호와 시각 기호 사이에 뚜렷한 분리가 나타나지 않았다.
- 자연스러운 결합: 모델이 시작부터 시각·텍스트 정보를 더 자연스럽게 통합하는 법을 배웠다는 뜻이다.
4. 멀티모달 아키텍처와 3D 어텐션
M3의 전체 구조는 표준적인 비전 변환기와 언어 모델 결합을 따르되, 영상의 시간축 상호작용을 위해 3D 어텐션을 적용했다.
4.1. 이미지·영상 정보를 언어 모델에 넣는 흐름
-
비전 변환기(Vision Transformer, ViT)
- 입력 처리: 이미지 또는 영상이 비전 변환기(ViT)로 들어간다.
- 시각 코드 생성: ViT가 시각 기호 또는 시각 코드(visual codes)를 생성한다.
-
텍스트 시퀀스와의 결합
- 이미지 위치 대체: 생성된 시각 기호를 텍스트 시퀀스 안의 원래 이미지 위치에 삽입하거나 그 위치를 대체한다.
- 임베딩 결합: 시각 임베딩과 텍스트 임베딩을 함께 언어 모델에 넣는다.
- 공통 추론 공간: 언어 모델은 동일한 입력 흐름에서 텍스트와 시각 정보를 처리한다.
4.2. 프레임 간 상호작용을 만드는 3D 어텐션
-
표준 ViT의 한계
- 이미지별 계산: 표준 비전 변환기에서는 각 이미지 또는 각 프레임 내부에서 어텐션이 계산된다.
- 프레임 간 단절: 영상 입력의 경우 서로 다른 프레임의 시각 패치가 ViT 단계에서 직접 상호작용하지 않는다.
- 시간 정보 부족: 프레임 사이의 변화를 모델링하려면 별도 구조가 필요하다.
-
3D 어텐션(3D Attention)의 작동
- 패치 간 직접 주의: 3D 어텐션은 서로 다른 프레임에 있는 패치들이 서로 직접 어텐션을 주고받게 한다.
- 시간·프레임 모델링: 모델이 여러 프레임과 시간에 걸친 시각 변화를 더 강하게 표현할 수 있다.
- 이해 능력 향상: 3D 어텐션은 시각 이해를 개선했고, 영상 전용 과제뿐 아니라 일부 이미지 파라미터에도 이점이 확장됐다.
- 일반 표현 개선: 영상 처리만 좋아지는 것이 아니라 전체 시각 표현(visual representation)을 강화한다.
-
프레임 수와 시스템 균형
- 무제한 확장의 문제: 3D 어텐션을 무한히 많은 프레임에 적용하면 시스템 복잡도와 로드 밸런싱(load balancing) 문제가 커진다.
- 네 프레임의 균형: 실험에서는 네 프레임을 사용하는 설정이 성능과 효율 사이에서 가장 좋은 균형을 제공했다.
- 실용적 선택: 프레임 간 상호작용의 장점을 얻으면서 계산·시스템 부담을 제한하는 선택이다.
주요 발언 모음
“A simpler structure always results in better expansion characteristics.”
“더 단순한 구조는 언제나 더 나은 확장 특성을 만든다.”
“Our design is not guided solely by algorithms.”
“우리 설계는 알고리즘만으로 결정되지 않는다.”
“Different KV heads can pay attention to different sets of symbols.”
“서로 다른 KV 헤드는 서로 다른 기호 집합에 어텐션을 둘 수 있다.”
“We moved from token-level selection to block-level retrieval.”
“토큰 수준 선택에서 블록 수준 검색으로 옮겼다.”
“Under the same text token budget, we found that this approach does virtually no harm to text capability.”
“같은 텍스트 토큰 예산에서 이 접근법은 텍스트 능력에 사실상 해를 주지 않았다.”
“Multimedia is not fully integrated.”
“멀티모달 정보가 완전히 통합되지 않았다는 뜻이다.”
“The benefit extends to some image parameters as well.”
“그 이점은 일부 이미지 파라미터에도 확장됐다.”
“The use of four frames gave us the best balance between performance and efficiency.”
“네 프레임 사용이 성능과 효율 사이에서 가장 좋은 균형을 제공했다.”
핵심 데이터 & 수치
- 100만 토큰/기호 컨텍스트: M3가 긴 사용자 상호작용과 전체 코드베이스를 처리할 수 있도록 지원하는 컨텍스트 창이다.
- 90% 프로그래밍 작업: M3가 처리할 수 있도록 설계된 현재 프로그래밍 업무의 범위다.
- 9배 프리필 속도: MSA가 full attention보다 초기 컨텍스트 채우기(prefill)에서 빠른 정도다.
- 15배 디코딩 속도: MSA가 full attention보다 토큰 생성(decoding)에서 빠른 정도다.
- 4개 쿼리 헤드와 1개 키 헤드: MSA 인덱싱 브랜치의 헤드 구성이다.
- 1×512 대 4×128: MQA의 비교적 연속적인 KV 메모리 배치와 GQA의 분할된 KV 헤드 배치를 설명하는 예시다.
- 네 프레임: 3D 어텐션에서 성능과 효율의 균형이 가장 좋았던 프레임 수다.
- 텍스트 토큰 예산 동일: 처음부터 멀티모달로 학습해도 같은 텍스트 예산에서 텍스트 능력에 사실상 큰 손상이 없었다.
결론 및 시사점
-
긴 컨텍스트는 알고리즘과 하드웨어를 동시에 설계해야 한다
- 희소 어텐션의 이론적 계산량만 줄여서는 실제 GPU 효율을 보장할 수 없다.
- GQA 헤드별 다양성, 인접 메모리 읽기, Top-K 병렬화, 학습·추론 코어를 하나의 설계 문제로 다뤄야 한다.
-
블록 단위 희소성은 실용적인 시스템 경로를 제공한다
- 토큰 단위 선택보다 후보와 메모리 접근을 줄여 계산량 대 메모리 접근량 비율을 높인다.
- 선택 결과를 KV 헤드별로 유지하면 GQA의 다양성을 잃지 않으면서 성능 저하를 크게 만들지 않는다.
-
네이티브 멀티모달리티는 사후 부착과 다른 표현을 만든다
- 수렴한 텍스트 모델에 비전 데이터를 추가하면 텍스트 능력과 충돌할 수 있다.
- 처음부터 텍스트·비전을 함께 학습하면 어텐션 맵에서 두 정보 유형의 경계가 약해지고 더 자연스러운 통합이 나타난다.
-
영상 이해에는 시간축 상호작용이 중요하다
- 프레임별 독립 어텐션보다 3D 어텐션이 프레임 사이의 패치 관계를 직접 모델링한다.
- 네 프레임 설정은 무제한 확장에 따른 로드 밸런싱 부담을 제한하면서 시각 표현을 개선한다.
-
M3의 핵심은 세 요소의 결합이다
- 에이전트와 프로그래밍 능력은 실제 작업 자동화를 겨냥한다.
- MSA는 백만 토큰 컨텍스트를 현실적인 비용으로 처리하게 한다.
- 처음부터의 멀티모달 학습과 3D 어텐션은 텍스트·이미지·영상 이해를 하나의 모델 표현으로 통합한다.
Olive Song은 MiniMax의 M3 설계를 소개하며 발표를 마무리하고 청중에게 감사를 전했다.